2025年の振り返り
2022年、2023年、2024年と毎年振り返りを書いてきた。年が明けてしまったが、同じように1年を通して何があったのか、何を考えていたのかを整理しておきたい。
転職
2025年の大きな出来事のひとつは転職だった。
前職では、基本的に1人開発のプロジェクトが多く、裁量が大きい分、設計から実装、運用まで幅広く経験することができた。一方で、1人開発ゆえにプロジェクトの進行が思うように前に進まなかったり、自分の知識や経験がそのままプロジェクトの上限になってしまっているような感覚も強くなっていった。
このままでは成長が頭打ちになると感じ、新しい挑戦ができる環境に身を置きたいと思うようになった。具体的には、自分よりも技術的にできる人が多くいること、技術的な挑戦があること、そして大規模なデータを扱っていることを軸に転職活動を行った。結果として、4月に転職することになった。
自作・低レイヤーへの挑戦
転職期間の合間、有給をまとめて取得できた12日間を使って、技術基盤を自作するチャレンジを行った。
【#uesho有給開発チャレンジ 完結報告】
— uesho (@uesholib) 2025年3月31日
「AI時代に出力と理解のギャップを埋めるには低レイヤーの理解が必要」という仮説のもと、有給12日間で技術基盤を実装するチャレンジを完走しました!
自作OS/DNS/Web/Docker/TCP/IP/ルーター/RDBMS等、低レイヤーから構築し動作原理を体得できました。
きっかけは、「AI時代において、出力は簡単に得られる一方で、理解とのギャップはむしろ広がっているのではないか」という問題意識だった。このギャップを埋めるには、低レイヤーの理解が必要なのではないか、という仮説のもとで取り組んだ。 具体的には、自作OS、DNS、Webサーバー、Docker、TCP/IP、ルーター、RDBMSなどを、できるだけ低いレイヤーから実装し、実際に動かすところまでを目標にした。実装の多くではAIをかなり積極的に使っており、正直なところ理解が浅い部分も多い。それでも、ブラックボックスだった仕組みの解像度が一段上がった感覚は確かにあった。"分かっていない"ことが、以前よりも正確に分かるようになったという意味で、非常に良い経験だったと思う。
短期間ではあったが、このチャレンジを完走できたこと自体が大きな自信にもなった。やってよかった、と素直に思える取り組みだった。
部署異動
4月に転職してからは、ありがたいことに大規模な開発に関わる機会を多く得ることができた。これまでとはスケールの違うシステムや意思決定のスピードに触れ、学ぶことも多かったと思う。
一方で、環境の変化やプレッシャーもあり、体調を崩してしまい、約半年で部署異動することになった。
結果としては苦い経験ではあるが、自分の限界やコンディションの重要性を強く意識するきっかけにもなった1年だった。
家探し
親戚の方から「所有しているマンションの一室を買わないか」という相談を受けたことをきっかけに、家について真剣に考え始めた1年でもあった。
当初はそのマンションを購入する可能性も検討したが、最終的には見送ることにした。その後、一軒家を買う方向で話が進み始め、注文住宅で家を建てるという選択肢が現実的になってきている。
家を買うのは子どもが生まれてから、と漠然と考えていたが、タイミングや縁もあり、想定より早く動き出すことになった。まだ確定ではないものの、生活の基盤について深く考える1年だったと思う。
英語
英語については、少し後退した一年だった。
2024年までは継続的に英語学習に取り組んでいたが、転職後は仕事で英語を使う機会がほとんどなくなり、学習自体も次第に止まってしまった。シャドーイングだけは細々と続けていたものの、単語や表現はかなり抜け落ちている感覚がある。
ただ、部署異動先では英語を使う機会が出てきそうなので、これを機に英語学習を再開したいと考えている。これまで積み上げてきたものを完全に無駄にしないためにも、無理のない形で続けていきたい。
2026年に向けて
2025年を振り返って強く感じるのは、「正解がない状況」に向き合い続けることの怖さとプレッシャーだった。
何が正しいのか分からない中で意思決定を重ねること自体も大きな負荷だったが、それ以上に、周囲のリーダーと自分を比較し続けてしまったことが、メンタルを崩した一番の要因だったように思う。不確実な状況でも迷いなく判断しているように見える人たちと比べて、自分は劣っているのではないか、と感じ続けていた。
それでも、この経験を通してはっきりしたこともある。自分は、不確実性の中でも前に進めるエンジニアになりたいし、技術的な課題をきちんと解決できる人間でありたい。
一方で、最近は意思決定そのものに強いプレッシャーを感じるようにもなっている。だからこそ2026年は、ただ判断力を鍛えるのではなく、判断に耐えられる思考体力と土台を作る一年にしたいと考えている。
英語、エンジニアリング、リーダーシップ、ファシリテーション、そして意思決定。これらを個別のスキルとして追いかけるのではなく、不確実な状況に対応するための一つの能力として、少しずつ磨いていきたい。
Appendix
MCPサーバーを実装してわかったこと
はじめに
KotlinでObsidian用のMCPサーバーを実装してみました。そこでMCPについてわかったことをまとめていきます。
【#uesho有給開発チャレンジ 8日目】
— uesho (@uesholib) 2025年3月27日
KotlinでObsidianのMCPサーバーを作成した。まだ微妙な部分はあるが、基本機能は実装したぞ! pic.twitter.com/qZ5R4I7dSR
MCPとは
MCP(Model Context Protocol)とは、Anthropic社によって策定されたAIエージェントが外部サービスから情報を参照したり連携することを目的としたプロトコルです。
MCPの主な目的は、AIモデル(Claude等)と外部システムとの間の標準化されたインターフェースを提供することにあります。従来のAIシステムでは、外部データへのアクセスや機能の拡張に制約がありましたが、MCPによってAIが以下のことを行えるようになります。
- 外部データソースからリアルタイムの情報を取得・更新する
- 特定のドメイン専用の機能(ツール)を実行する
- 長期的な状態を維持し、複雑なタスクを継続的に処理する
MCPは特に、AIが「ハルシネーション」(実在しない情報の生成)を減らし、最新かつ正確な情報に基づいて動作するために重要です。また、AIの能力を拡張し、より専門的なタスクを実行できるようにする役割も果たします。
MCPのアーキテクチャ:クライアントとサーバー
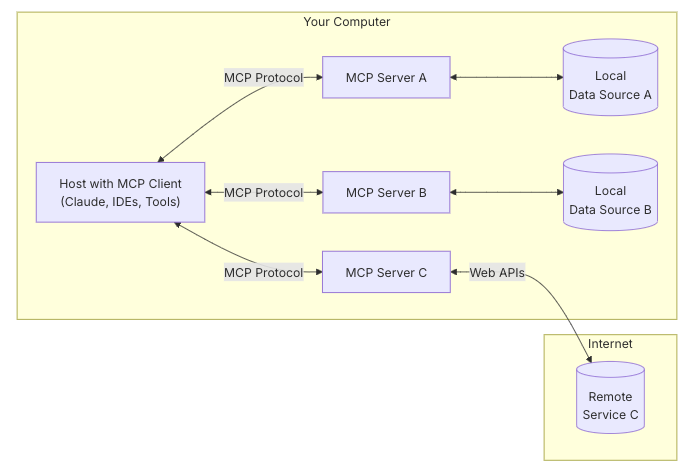
MCPは基本的に「クライアント-サーバー」モデルに基づいています。
MCPクライアント
MCPクライアントは、AIモデル(Claude等)とその基盤となるシステムです。クライアントは以下の責任を持ちます。
- ユーザーの入力を受け取り、それを処理する
- 必要に応じてMCPサーバーにリクエストを送信する
- サーバーからのレスポンスを解釈し、それを活用する
- 最終的な応答をユーザーに提供する
Claude等のAIモデル自体がMCPクライアントとして機能し、開発者はこのクライアント側の実装を直接制御することはありません。Anthropicがクライアント側の実装を管理しています。クライアント側のカスタム実装が必要な場合は、公式SDKを使用することも可能です。
MCPサーバー
MCPサーバーは、開発者が実装する外部サービスです。サーバーは以下の責任を持ちます。
- AIクライアントからのリクエストを受け取り、処理する
- リソース、ツール、プロンプトを提供する
- 外部システム(データベース、API、ファイルシステムなど)との統合
- 結果をAIクライアントに返送する
サーバーは特定のドメインやサービス(今回の例ではObsidian)に特化した機能を提供し、AIがそのドメインの専門知識や機能にアクセスできるようにします。
クライアント-サーバー間の通信
MCPクライアントとサーバー間の通信は、標準化されたJSONベースのメッセージング形式を使用します。これにより、異なる言語やプラットフォームで実装されたサーバーとの相互運用性が確保されます。
通信フロー: 1. ユーザーがAIに質問やタスクを提示 2. AIモデル(クライアント)が外部情報が必要と判断 3. クライアントがMCPサーバーにリクエストを送信 4. サーバーがリクエストを処理し、結果を返送 5. クライアントが結果を解釈し、ユーザーに応答
この通信プロセスは、ユーザーからは透過的に行われ、AIとの自然な対話の一部として機能します。
公式のSDK
公式のSDKは以下のリポジトリにあります。今回自分はKotlinのSDKを使って作成しました。
modelcontextprotocol repositories · GitHub
- TypeScript
- Python
- C#
- Java
- Kotlin
- Rust
これらのSDKは、MCPサーバーの開発を容易にするためのライブラリとツールを提供しています。各言語の特性を活かしつつ、MCPの仕様に準拠したサーバーを実装できるようになっています。
MCPサーバーの実装
KotlinでMCPサーバーを実装した経験から得られた知見をまとめます。MCPには主に3つの連携方法(リソース、ツール、プロンプト)がありますが、今回の実装ではその中でもツールのみを実装しました。
MCPの連携方法
1. リソース(Resources)
MCPにおけるリソースは、AIエージェントがアクセスできる外部データの抽象的な表現です。例えば、Obsidianのノート、ファイルシステム内のファイル、データベースのレコードなどがリソースになります。
リソースの特徴: - 固有の識別子(URI)を持ち、AIがそれを参照できる - 例 - file:///home/user/documents/report.pdf - postgres://database/customers/schema - screen://localhost/display1 - メタデータと実際の内容を分離して効率的に管理 - サブスクリプション機能により、AIがリソースの変更を監視可能 - AIがリソースリストの変更を検知する機能も提供
Resources - Model Context Protocol
2. ツール(Tools)
ツールはAIエージェントが実行できる関数です。AIがある目的を達成するために呼び出せる機能をサーバー側で定義します。今回の実装ではこのツール機能に焦点を当てて開発しました。
ツールの特徴: - 明確な名前と説明文を持ち、AIが適切なタイミングで呼び出せる - 入力パラメータと出力形式を定義できる - 非同期処理が可能で、長時間実行されるタスクも扱える - エラーハンドリング機能により、AIに問題を適切に伝達できる
Obsidian連携のために実装したツールには、ファイル一覧の取得、ファイル内容の読み取り、ファイルの作成・更新などがあります。これらのツールにより、AIがObsidianのVault内のデータを操作できるようになりました。
Tools - Model Context Protocol
3. プロンプト(Prompts)
MCPでは、サーバーがAIに対して追加のプロンプトやコンテキスト情報を提供することができます。これにより、AIの応答をより適切に導くことが可能になります。
プロンプトの利点: - AIの行動やレスポンスを特定の方向に誘導できる - ドメイン固有の情報や制約をAIに伝えられる - ユーザーからは見えない裏側の指示としても機能する - リソースやツールの使用方法についてのヒントを含められる
今回の実装では、基本的なプロンプト機能を有効化していますが、主にツールの説明文自体がAIの行動を導くプロンプトとして機能しています。
Prompts - Model Context Protocol
接続方法
MCPサーバーの実装には、AIモデルとの接続方法として主に2つのアプローチがあります。
1. 標準入出力(今回採用)
標準入出力(STDIO)を使った接続は、最もシンプルな実装方法です。
特徴: - 実装が容易でデバッグしやすい - ローカル環境での開発に適している - プロセス間通信として効率的 - 外部からの接続に追加の設定が不要
今回のObsidianクライアントでは、この標準入出力方式を採用しました。AIからのリクエストはStdinから受け取り、レスポンスはStdoutに返すという単純な構造です。この方式は特にMCPのローカルテストに適しています。
今回の実装では、Obsidianの[Local REST API] (https://github.com/coddingtonbear/obsidian-local-rest- api)プラグインを用いてローカルで動作させ、ローカルのCursorに以下の設定を追加することでローカル起動しています。このようなローカル環境では、標準入出力方式で十分に機能します。
{
    "mcpServers": {
        "obsidian": {
            "command": "java",
            "args": [
                "-jar",
                "/Users/uesho/develop/uesho-yukyu-dev/mcp-obsidian-kotlin/app/build/libs/app.jar"
            ]
        }
    }
}
2. SSE(Server-Sent Events)
SSEは、サーバーからクライアントへの一方向通信チャネルを確立するプロトコルです。
特徴: - HTTPベースで実装が比較的容易 - 長時間接続を維持し、サーバーから必要に応じてイベントを送信 - WebSocketよりも単純で、HTTP標準に準拠 - 再接続メカニズムが標準で組み込まれている
SSE方式では、MCPサーバーがHTTPエンドポイントを提供し、AIシステムがそこに接続してイベントを受信します。この方式は、特に複数のAIセッションをサポートするような環境に適しています。
最後に
MCPについて全然わかっていませんでしたが、今回実装してみて理解が進みました。OpenAIもMCPをサポートすると発表しており、今後どんどん普及していくと思われます。一度実装してしまえば理解が深まりますし、SDKを使えば比較的簡単に実装できるので、皆さんも使うだけでなく実装してみることをお勧めします。
TCP/IP プロトコルスタックを自作する
はじめに
3/19に最終出社日を終え、4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行ってます。 今回はTCP/IPプロトコルの仕組みを深く理解するために、自分でTCP/IPスタックを実装するプロジェクトに2日間かけて挑戦しました。
【#uesho有給開発チャレンジ 6日目】
— uesho (@uesholib) 2025年3月25日
C++でTCP/IPを自作中。ARP、IP、ICMPまで実装済み。
明日TCPと可能ならUDPも実装予定。 https://t.co/y6FBvg0o1T
【#uesho有給開発チャレンジ 7日目】
— uesho (@uesholib) 2025年3月26日
今日はTCPを実装し、「完全に理解した」程度進んだ。3ウェイハンドシェイクやフラグ周りが鮮明に見えてきた。
お供の「マスタリングTCP/IP」がかなり役立った。
UDPの実装は別の機会に挑戦したい。 https://t.co/wksqEbmzc3
学んだこと
TCP/IPスタックを実装することで、各層(データリンク層、ネットワーク層、トランスポート層)がどのように連携して動作するのかを実際のコードレベルで理解できました。特に、以下の点が明確になりました。特にTCPの3ウェイハンドシェイクの理解が深まったので良かったです。
- イーサネットフレームの構造と処理方法
- ARP(Address Resolution Protocol)による物理アドレス解決の仕組み
- IPパケットの構築と経路制御の基礎
- ICMPプロトコルの役割とエコー要求/応答の実装
- TCPの接続確立や信頼性確保の複雑さ
AIを活用した実装支援
今の時代、AIを活用することで開発効率を大幅に向上させることができます。私も Cursor と Claude-3.7-sonnet を使いながら段階的な実装アプローチを行いました。TCP/IPスタックを1から自分で実装するのはしんどいのでこのようなアプローチは有効だと思います。各層をしっかりとテストしながら進めることで、後の複雑な問題を減らせます。
とは言っても、書籍もかなり役に立ちました。今回は以下をよく参考にしました。
- 書籍: マスタリングTCP/IP 入門編
- RFC文書: 各プロトコルの公式仕様書
- かわしんさんのブログと実装: https://kawasin73.hatenablog.com/entry/2019/08/30/174424
TCP/IPスタックは基本的にかなり難易度が高いプロジェクトだと思いますが、コーディングはAIでサポートしてもらいながら、実装をよく読み込んで、動かしながらやることで理解が深まると思います。
最後に
実はまだバグっているところがあったり、UDPを実装しきれていないので、別の機会でここら辺の実装をして理解を深めていきたいです。
ミニDockerを自作した
はじめに
3/19に最終出社日を終え、4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行ってます。 これはその5日目のチャレンジです。
プロジェクトの概要
Dockerのようなコンテナランタイムを生成AIを使いながらゼロから実装したプロジェクトを紹介します。このプロジェクトは、コンテナ技術の基本的な概念を理解するために、Kotlinを使って実装されています。
【#uesho有給開発チャレンジ 5日目】
— uesho (@uesholib) 2025年3月24日
Dockerのようなコンテナを自作。イメージの作成・削除、コンテナの実行を実装。 pic.twitter.com/ye8cWlh0kJ
この動画は、/home/uesho/test-image というディレクトリをコンテナイメージ test-image:5.0 としてビルドを行い、そのイメージを実行しています。
このコンテナランタイムは以下のコンポーネントから構成されています。
- Container.kt - メインのコンテナ操作(実行、イメージのビルド、一覧表示など)
- CgroupManager.kt - リソース制限の管理
- FilesystemManager.kt - ファイルシステムの分離と管理
- ImageStorage.kt - イメージの保存と管理
実装したリポジトリはこちら
名前空間の分離とプロセスの隔離
Linuxの名前空間(namespaces)は、コンテナ技術の核心部分です。このプロジェクトではunshareコマンドを使って、以下の名前空間を分離しています。
val processBuilder = ProcessBuilder(
    "unshare",
    "--pid",     // PIDの名前空間を分離
    "--uts",     // UTSの名前空間を分離
    "--mount",   // マウントの名前空間を分離
    "--fork",    // 新しいプロセスをフォーク
    "--mount-proc", // /procファイルシステムをマウント
    "--kill-child", // 親プロセスが死んだら子プロセスを殺す
    "chroot",    // ルートディレクトリを変更
    fsManager.getContainerRoot(),
    "/container_init.sh"
)
これにより、コンテナ内のプロセスは隔離され、ホストシステムのプロセスからは見えなくなります。
cgroupsによるリソース制限
コンテナの重要な特徴の一つは、リソース使用量を制限できることです。このプロジェクトでは、cgroupsを使用してメモリとCPUの使用量を制限しています。
// メモリ制限の設定(例:512MB)
cgroupManager.setMemoryLimit(512 * 1024 * 1024)

// CPU割り当ての制限(例:CPUの50%)
cgroupManager.setCpuQuota(50000)
CgroupManagerクラスは、cgroupsのv2を使用してリソース制限を実装しています。具体的には以下を行なっています。
- コンテナ専用のcgroupディレクトリを作成
- メモリとCPUのコントローラーを有効化
- リソース制限値をcgroupファイルに書き込み
- コンテナプロセスをcgroupに追加
ファイルシステムの分離
コンテナはホストシステムから分離された独自のファイルシステムを持ちます。このプロジェクトでは以下の処理を行なっています。
- 一時的なコンテナルートディレクトリを作成
- 必要な基本ディレクトリ構造を作成
- chrootを使用してルートディレクトリを変更
- 仮想ファイルシステム(/proc, /sys, /dev)をマウント
コンテナイメージの管理
Dockerと同様に、このプロジェクトではコンテナイメージの概念を実装しています。
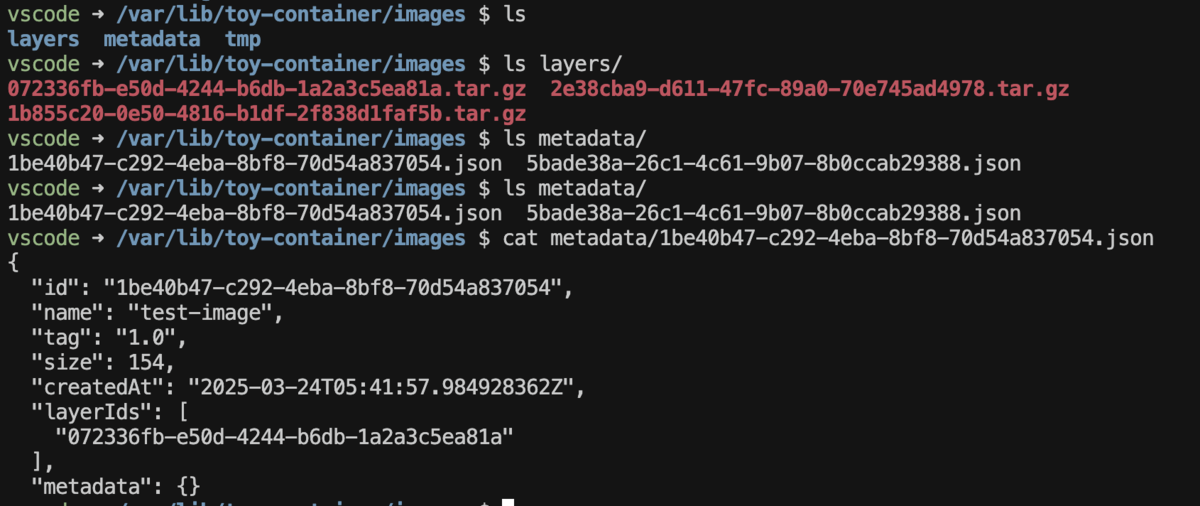
- イメージのビルド - 指定したディレクトリからtar.gzアーカイブを作成
- イメージの一覧表示 - 保存されたイメージのメタデータを表示
- イメージの抽出 - コンテナ実行時にイメージを展開
- イメージの削除 - 不要になったイメージを削除
Dockerの「なぜ」が理解できた
Dockerで異なるOSを指定するとなぜそれが起動できるのか疑問でしたが、実際にコンテナランタイムを実装したことで理解できました。それはルートファイルシステムの交換がカギとなっています。
Dockerなどのコンテナ技術は、Linuxカーネルを共有していますが、ルートファイルシステムは交換できます。例えばUbuntuのコンテナを実行する場合
- Ubuntuのルートファイルシステムを含むイメージを用意
- コンテナ起動時にそのファイルシステムをマウント
- chrootコマンドでルートディレクトリを変更
- unshareでプロセス空間を隔離
これにより、同じLinuxカーネルを使いながら、異なるディストリビューションの「ふりをした」環境が作れるのです。ただし、カーネルがまったく異なるのでWindows用のコンテナをLinuxホストで実行することはできません。
まとめ
このプロジェクトを通じて、コンテナの基本的なメカニズムである「名前空間による分離」「cgroupsによるリソース制限」「ファイルシステムの分離」を実装しました。これによりDockerのような本格的なコンテナエンジンの動作原理が理解できました。そして、今までOS, DNS, Webサーバーを自作してきましたが、その中でも1番面白かったです。
Linuxカーネルの機能を直接利用することで、軽量かつ効率的な分離環境を実現できるのがコンテナ技術の大きな魅力です。今回実装したシンプルなコンテナランタイムは、その基本的なメカニズムを学ぶための良い教材となりました。
DNSサーバーを自作した
DNSサーバー実装から学んだこと
はじめに
3/19に最終出社日を終え、4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行ってます。 これはその3日目のチャレンジです。
昨日が最終出社日でした!4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行います。1日1プロダクトを目標にアウトプットします! #uesho有給開発チャレンジ
— uesho (@uesholib) 2025年3月20日
プロジェクトの概要
How to Build DNS Server in X Programming Language という記事があり、実装方法として JavaScript と Ruby の2つが紹介されています。私は Kotlin で実装しました。
実際に作成したリポジトリはこちらです。 github.com
DNSサーバーは普段何気なく使っていてあまり理解していなかったので、今回のプロジェクトではシンプルなDNSサーバーを実装することで、DNSの内部動作について理解することができました。 以前からAWS Route53でDNSレコードを追加する経験はありましたが、その裏側で何が起きているのかを理解していませんでした。Route53でレコードを追加するというのは、実際にはDNSのゾーンファイルに情報を追加しているんだなとわかりました。(違ったら教えてください)
感想
DNSサーバーの実装で特に興味深かったのは、マスターファイル(ゾーンファイル)のパース処理です。ゾーンファイルは以下のような構造になっています。
$ORIGIN example.com.
$TTL 86400

; SOA Record
@       IN      SOA     ns1.example.com. admin.example.com. (
                        2023010101 ; Serial
                        3600       ; Refresh
                        1800       ; Retry
                        604800     ; Expire
                        86400 )    ; Minimum TTL

; A Records
@       IN      A       192.168.1.1
www     IN      A       192.168.1.2
このファイルをパースして、A、NS、MX、CNAME、SOAなどの各種DNSレコードを解析する処理を実装しました。 How to Build DNS Server in X Programming Language の記事を見ながら実装したが、正直コードが汚くて、リファクタリングするのに時間がかかりました。
途中からClaude 3.7 Sonnetを使って実装を進めましたが、本当にすごくて、かなりコードが綺麗に実装してくれました。パケットの処理周りを丸っと実装してくれたので、まだ自分の理解が浅い状態です。これからパケット見ながら、より深い理解を得たいです。 Claudeは単にコードを生成するだけでなく、DNSプロトコルの仕組みや実装上の注意点などもドキュメントにしてくれたりと補助的にも使えてかなり役立ちました
最終的に、実装したDNSサーバーに対してdigコマンドを使って問い合わせができたときは、大きな達成感がありました。
dig @127.0.0.1 -p 53 example.com
レスポンスが正しく返ってきたときの喜びは何とも言えないものでした。特に、以下のようなさまざまなレコードタイプも正しく扱えるようになりました。
dig @127.0.0.1 -p 53 example.com A     # Aレコード問い合わせ
dig @127.0.0.1 -p 53 example.com MX    # MXレコード問い合わせ
まとめ
DNSサーバーの実装は、インターネットの基盤技術の理解を深める良い機会となりました。普段は当たり前のように使っているドメイン名解決の裏側が知れて良かったです。
また、Claude 3.7 Sonnetのような高度なAIツールを活用することで、複雑なプロジェクトでも効率的に進めることができることも学びました。技術的な知識とAIツールを組み合わせることで、より高度な学習と開発が可能になっているなと感じます。
1000行でOSを作ってみた
はじめに
3/19に最終出社日を終え、4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行ってます。 これはその2日目のチャレンジです。(1日目は低レイヤーではなく、Nixを使ってdotfilesの整理をしました。)
昨日が最終出社日でした!4/1までの有給期間を活用し、低レイヤー技術を中心に開発するチャレンジを行います。1日1プロダクトを目標にアウトプットします! #uesho有給開発チャレンジ
— uesho (@uesholib) 2025年3月20日
プロジェクトの概要
1000行でOSを作るというプロジェクトに取り組みました。このプロジェクトを通じて、OSの基本的な仕組みと実装について多くの学びを得ることができました。
実際に作成したリポジトリはこちらです。 github.com
このプロジェクトでは、以下の機能を持つ小規模なOSを実装しました。
- マルチタスク処理
- 例外ハンドラ
- ページング
- システムコール
- デバイスドライバ
- ファイルシステム
- コマンドラインシェル
感想
このプロジェクトを通じて、普段何気なく使っているOSの内部動作についてざっくりと理解を得ることができました。
社会人1, 2年目の時はWiFiの開発でC言語を使っていたので、C言語自体のコーディングには特に困りませんでした。ただ、アセンブリやレジスタの扱いについては、かなり理解が浅いままです。その後、Webエンジニアとして働く中で、メモリを直接意識するような開発がなくなっていたので、今回改めてメモリを意識したプログラミングの面白さを感じることができました。
プロセス管理とエラーハンドリングの実装は特に面白かったです。特にエラーハンドリングでは、発生したエラーの原因をメモリダンプと比較してコードの何行目が原因かと特定できるのを見た時は、「おおっ!こうやって特定しているのか!」と驚きました。
一方で、仮想アドレスとページング周りは難しく感じました。メモリ管理の概念自体の理解が曖昧だったため、実装を見ても理解が追いつかない部分が多くありました。ただ、この実装から、メモリ管理の基本的な仕組みについてもざっくりと理解することができ、価値のある経験になりました。
また、自作したOSでユーザーアプリケーションを動かす体験も楽しかったです。ファイルの読み書きはもちろんのこと、単純なexitコマンドが動作した時でさえ、達成感を感じました。普段何気なく使っているコマンドの裏側で動いている仕組みを、自分の手で実装し動作させることで、OSの役割をより理解することができました。特に、システムコールを通じてユーザーモードとカーネルモード間でデータをやり取りする仕組みを実装し、それが実際に動く様子を見られたことは、貴重な経験となりました。
まとめ
OSという普段はブラックボックスになっている層を実装することで、システムプログラミングの面白さと難しさを体験することができました。今でもレジスタ周りは正直あまり理解していないですが、これらの経験は、今後AIが発展しても、システムの全体像を理解する上で役立つんじゃないかなと思います。
時間があれば著者の 自作OSで学ぶマイクロカーネルの設計と実装(通称:エナガ本) にもチャレンジしてみたいです。
2024年の振り返り
毎年恒例の1年の振り返りをします。
英語
今年1年はエンジニアリングの時間を削って英語に注力した1年でした。
友人がTOEIC 815点だったので、820点以上取れることを目標にしていましたが全く及ばず、、、よく3ヶ月で900点とか見るので、1年勉強すれば800点は余裕で行けると思っていたが、そんな甘いものではなかったです。
英文のまま理解するのというのがまだ出来ていないので、頭の中で一回日本語に訳してしまいます。来年には何とかしたい。
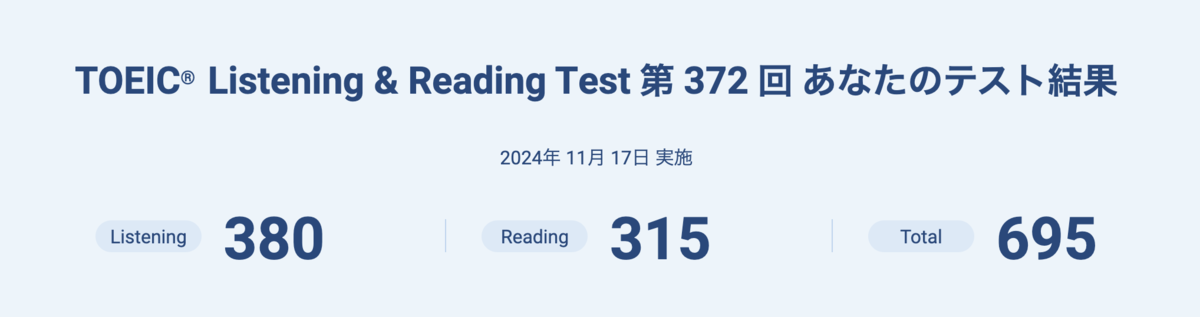
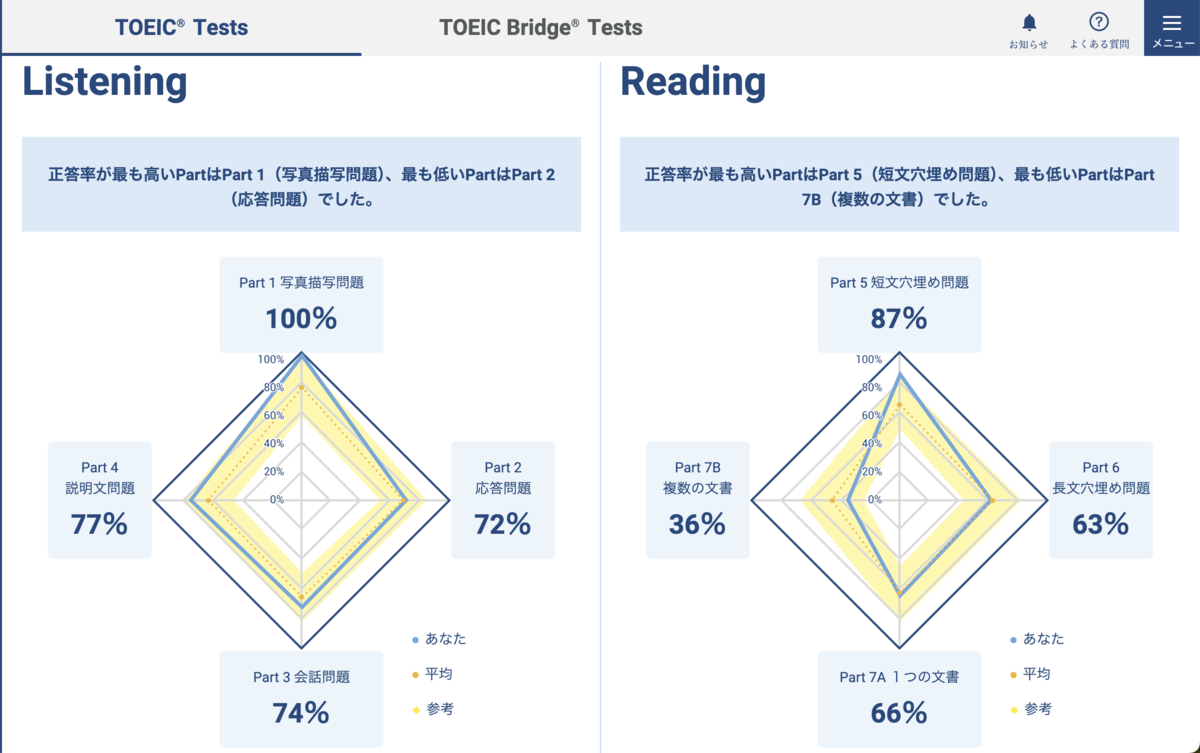
プログリットを受講して3ヶ月平均4時間勉強していたので、同僚とはだいぶ話せるようになってきました。ただ、グループでいる時は速すぎて聞き取れないことが多いので、来年も継続して英語は続けていきたい。
仕事
上司も少し参加はしていますが、今年も相変わらず基本的に1人で開発しています。デスクトップアプリ(Electron)、フロントエンド(Next.js)、バックエンド(FastAPI)、インフラ(AWS, Terraform)、AWS Lambdaのコード、CLIツール全般の開発を担っています。APIは約60個、DBテーブルは30弱ほどの規模で、そこまで大きいサービスではないですが全部のコードを把握して開発できているので、自分でも結構やっている方なんじゃないかと(?)
英語に注力していたと言いましたが、仕事で成果は出せたかなと思います。特に以下は良くできた成果かなと感じています。
- バックエンドのフレームワークをFastAPIへ移行し、Pydanticを用いて厳密な型定義と入力チェックを行い、データの整合性を確保できた。FastAPIによりOpenAPIドキュメントを自動生成し、フロントエンドとの連携をできるようにすることで開発効率を高めた。
- バックエンドでORMであるSQLAlchemyのモデルに実装があったりと肥大化していたので、DDD+CQRSベースでモジュールを分割して、保守性を向上させた。
- AWS Foundational Security Best Practicesに基づく指摘をもとに、リリース前にセキュリティリスクを最小限にした。また、AWS Config、Security Hub、DataDogを活用してSIEMを構築し、セキュリティアラートを実装することで、指摘事項を継続的に検知・監視し、セキュリティ問題に迅速に対応できる環境を整備し、AWSのセキュリティ基準に準拠した運用を実現できた。
- 外部ベンダーの脆弱性試験を実施し基準をパスした。本番リリースを無事に行なった。
- LocalStackを導入し、ローカル環境での開発を効率化する開発環境を整備した。(ここは別で記事を書きたい)
そろそろチーム開発がしたいです。
生活
結婚
大きいトピックとして、大学時代から付き合っていた彼女と今年の1月に入籍しました。その後、4月に結婚式を行い、7月にイタリアに新婚旅行に行きました。イタリアでは、しっかりと4万円ほどスられる事件がありましたが、初ヨーロッパを存分に楽しめました。
最高の1年となりましたが、お金もその分飛んで行きました💸
朝活
1月1日から毎日6:20に起きるということを継続できました。 友人とDiscordに6:20に集まって、10分だけ今日やることだったり雑談だったりを英語でするということをしていました。寝坊するというのが何回もありましたが、基本的に参加できたと思います。
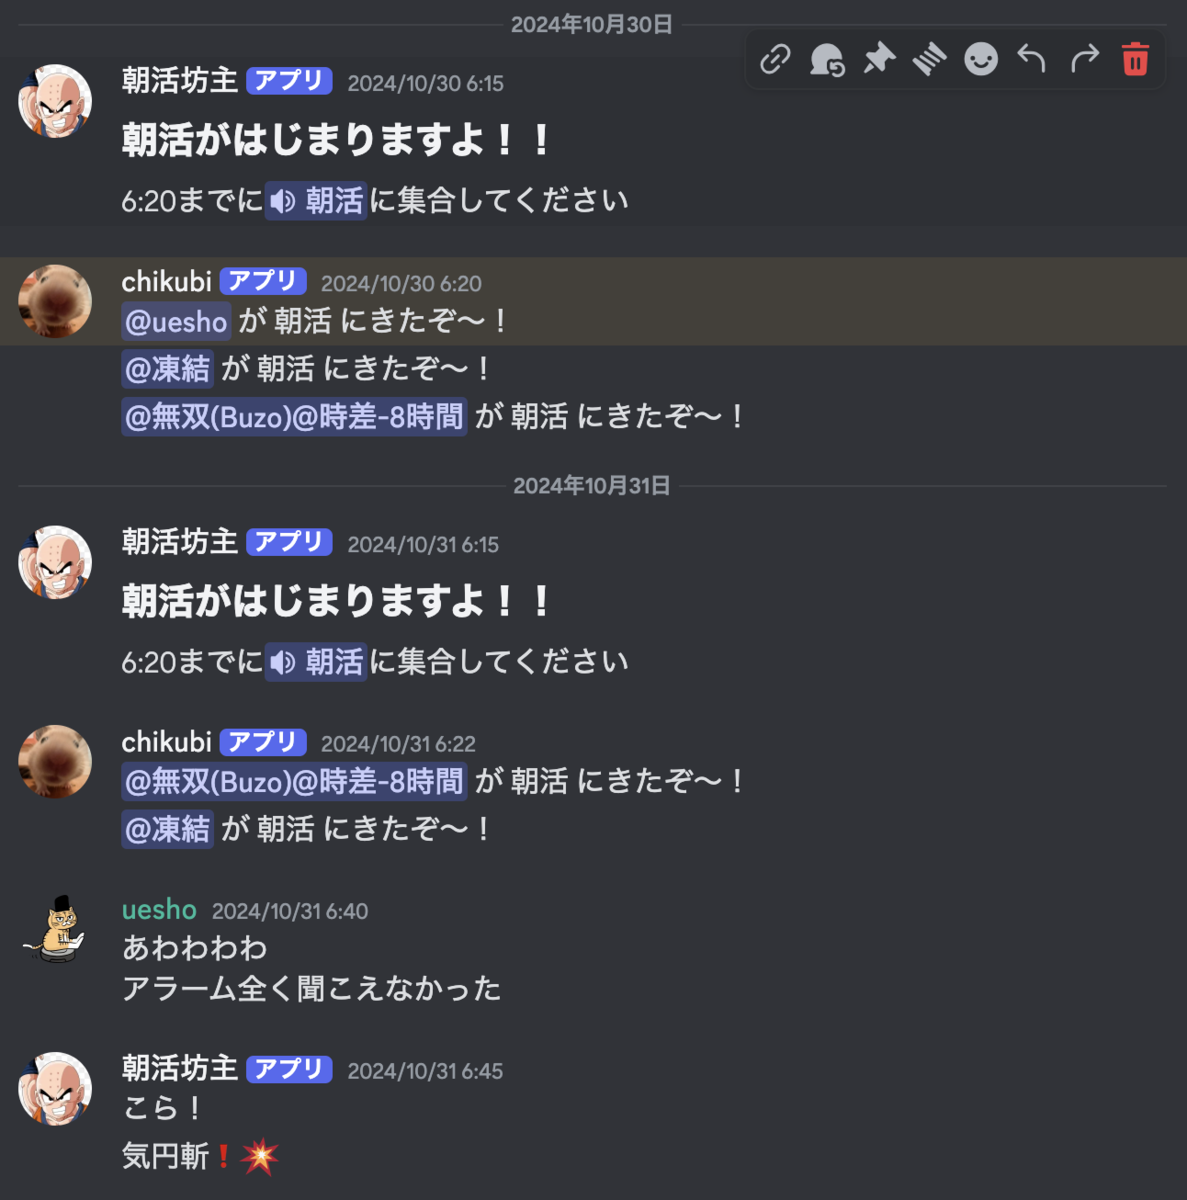
12月中旬ごろに友人がスペインに行ったので、そこからは強制力がなくなり朝活失敗し続けています。
エンジニアリング
OSS
Star数は100程度しかないですが、DICOM画像を扱うライブラリにいくつかPull Requestを作成しました。 初のOSSコントリビュートでしたが、mainブランチにマージされて良かったです。
Pull requests · KitwareMedical/dicom-anonymizer · GitHub
登壇
今年少なくても1回は登壇することを目標にしており、以下のイベントでLTしてきました。
https://kinto-technologies.connpass.com/event/310504/
以下のブログを書いていたところからお話をもらったので、AIでレビューしていることについて話しました。
ISUCON
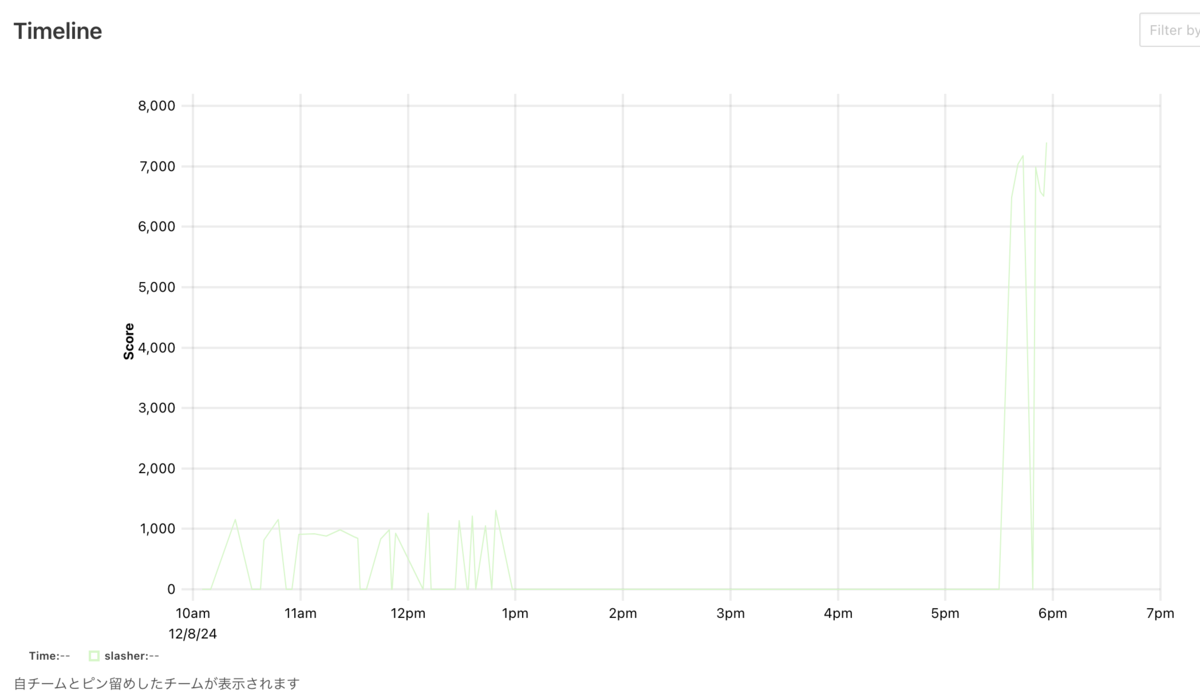
ブログ書けていないんですが、今年もISUCON参加しました。去年よりできることが増えましたが、結果は254位/834組でした。

13時ごろからアプリとDBのサーバーを分割したが、isuride-matcherを止め忘れでずっと0点で苦しみました。何とか得点が出て良かったです。
自作RDBMS
前回、シングルスレッドでトランザクション管理等がない簡素なDBを自作しました。
しかし、もっと深く知りたい、かつ、英語で学びたいということで Database Design and Implementation を読み始めています。 諸事情でストップしているので、来年までには完成させたい。
この1年英語に時間使っていたので業務外であんまり技術のことを触れていなかった。プログリットも終わったのでこれ基に自作RDBMS始めます!https://t.co/woozmc08uT
— uesho (@uesholib) 2024年10月17日
まとめ
いろんなイベントがあり、確実に成長した1年でした。来年はもっとアウトプット出しつつ、いろんなことを挑戦していきたいです。
今までの振り返りはこちら
kotsutsumi.hatenablog.com kotsutsumi.hatenablog.com kotsutsumi.hatenablog.com
